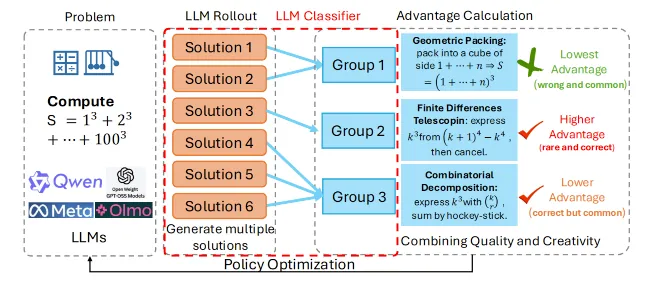
首页›洞察 / 博客›学术研究【学术研究】奖励稀缺,用Uniqueness-Aware RL治愈大模型的“策略懒惰病”当你让AI求解方程x²-5x+6=0,它连续给出32种解法,细看却发现全是二次求根公式的变体——这种“策略懒惰”并非玩笑,而是当前大语言模型强化学习中广泛存在的“探索崩塌”危机。正文加载中…