本历史事实
从真实场景、数据与约束出发,将 AI 问题的边界讲清楚。
围绕智能体、强化学习等技术,通过产学研联合的方式持续展开研究、探索与实验,并将研究成果沉淀为探索经验与产品。
“言表”借自墨子的言表之说,也对应我们认知世界的过程:先回到事实,再经过推演,最后交给实践验证。
从真实场景、数据与约束出发,将 AI 问题的边界讲清楚。
把业务逻辑、领域知识与推理路径组织成可讨论、可复用的方法。
在产品、案例与真实流程中验证效果、边界与长期价值。
以真实任务、轨迹评测与持续训练闭环,构建可运行、可复用的智能体学习基础设施。
将大模型、智能体与 Lean 形式化验证结合,让推理结论在机器校验中持续修正与积累。
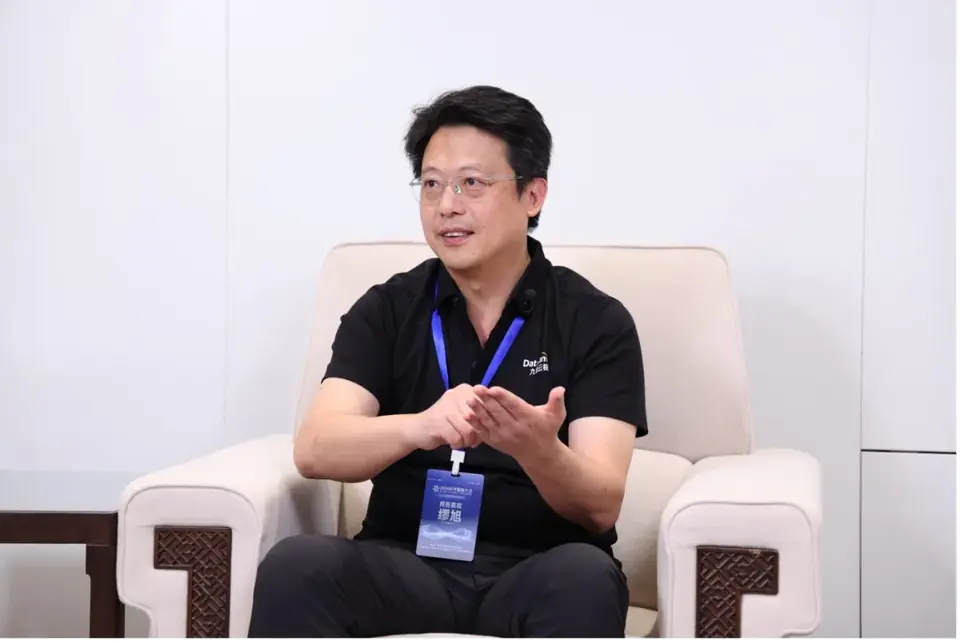
缪旭在AI for Science基础理论平行会议期间接受采访,分享了对科学智能发展路径的观察:AI正在从竞赛解题走向研究探索,但仍需解决科学数据缺失、模型推理边界与结果验证等问题。
阅读全文
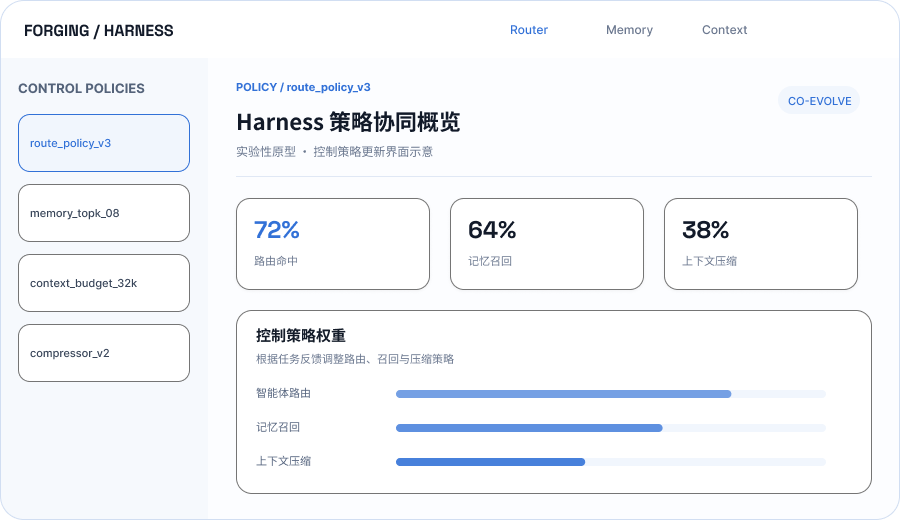
智能体完成了任务,却未必能从任务中学到什么。ForgingMA 通过记录规划、协作与工具调用过程,将环境反馈转化为持续优化信号,推动智能体从"完成一次任务"走向"在一类任务中持续变强"。项目现已基于 MIT License 开源。
阅读全文
最近刚交付了一个金融保险领域的 AI Agent 优化项目,其中关键信息提取环节从最初 20%+ 的惨淡准确率一路提升到最终稳定在 95% 左右,整个过程踩了不少坑,也积累了值得分享的落地经验。
阅读全文
一家在线教育平台的古诗词教学产品在持续运营中遭遇增长瓶颈。尽管其AI工作流能够稳定输出基础解析和配图,但用户调研显示:"每首诗的画面雷同度太高""长诗只能看到片段""现代诗配古风画显得突兀"。更关键的是,当学生尝试输入"描写孤独场景的诗"时,系统直接报错——它只能识别精确诗名,无法理解意境描述。
阅读全文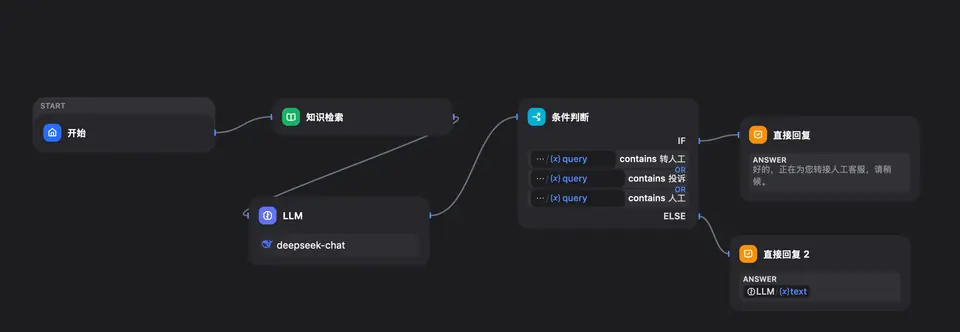
在很长一段时间里,系统的表现都是“正常的”。
阅读全文
去年底,一家公众号内容平台的AI写作团队陷入了瓶颈。他们的爆款文章生成器在经过初期快速提升后,进入了长达3个月的“平台期”——无论怎样调整prompt,文章质量评分始终卡在72分左右,无法突破。
阅读全文实验室介绍
“言表”借自墨子的言表之说,也对应我们认知世界的过程:先回到事实,再经过推演,最后交给实践验证。
我们探索“智能”的本体,构建可推理、可协作、可演化的 AI 系统,推动人机共生的未来。
近期动态
加入我们